GIT-Branches/Tags entmüllen

Bei der Softwareentwicklung mit git und Pull-Requests passiert es, dass sich peu-a-peu immer mehr Branches ansammeln. Man verwendet sie, um den Pull-Request zu stellen und wenn man vergisst, den Zweig am Ende zu löschen (oft gibt es eine Checkbox, um den PR-Zweig zu löschen), dann entstehen so langsam Abfallbranches. Also Zweige, die keiner mehr braucht, aber dennoch da sind. Eigentlich sind die Änderungen darin schon längst auf den Hauptast gelangt, aber sie sind eben noch da.

Da muss man halt dann ab und zu mal aufräumen

Wie auch immer: Ran an die Arbeit.

Wie man es macht

Wenn man also mal die Refs (so heißen Tags und Branches zusammen) ausdünnen will, sollte man da nicht manuell durch die Liste durchgehen und Klickorgien zelebrieren. Nein, man sollte ein Skript ausführen, das das Ganze recht automatisch macht. Ich habe dazu mal ein Powershell (PS)-Skript geschrieben, dass die Refs auf dem Remote-Git-Server löscht.

Probleme

Wie immer, so ist auch diese Aufgabe nicht ganz trivial. Da es sich hier um ein Windows-Skript handelt und git eh nicht so ganz Windows-native ist, kommen als erstes Kodierungsprobleme.

Zweige, Tags und Refs werden durchaus mit Umlauten bzw. generell Unicode-Zeichen benutzt und dann haben sie auch noch manchmal „/“ Schrägstriche. Und zu allem Überfluss ist der Unicode-Support auf der Windows-Console eher Mist.

Ein zweiter Aspekt sind die Mitmenschen. Zweige veralten und man kann mit 4 Wochen schon mal ein gutes Maß anlegen, ob es ein Löschkandidat ist. Allerdings gibt es auch Entwicklungen (auf Zweigen), die mehrere Wochen benötigen und Entwickler wollen die vielleicht aufheben. Daher sollte der Prozess des Löschens so sein, dass man zunächst eine Liste von Refs ermittelt, die man löschen würde, alle Mitentwickler fragt, und dann erst zur Löschung schreitet. Daher ist das Skript so gestaltet, dass es selbst ein Skript erstellt. Und zwar eine Liste von git-Befehlen „Löschen einer Ref“.

Ausführen

Lass uns zur Sache gehen. Das Skript nehmen und in einem git-VZ ausführen:

cd GitVZ
# Skript ist herkopiert und wird im Repo-VZ ausgeführt. Ausgabe wird in ‚deletescript.ps1‘ umgeleitet
search_branches2delete.ps1 > deletescript.ps1
# Nun das ‚deletescript.ps1‘ in Notepad++ anschauen und im Zweifelsfall nachbearbeiten
npp ./deletescript.ps1
# wenn alles klar ist ausführen:
./deletescript.ps1

Ergebnis ist, dass alle ermittelten Refs gelöscht werden.

Was passiert

Das Skript ermittelt alle Refs und wählt veraltete Branches aus und schreibt auf standard-out die Befehle zum Löschen der betreffenden Branches. Daher wird die Ausgabe mit dem Shelloperator ‚>‘ in eine *.ps1 – Datei umgeleitet. Fehlermeldungen landen auf standard-err und sind somit weiterhin sichtbar.

Das Ergebnis in der umgeleiteten Datei:

 git push :orign/remotes/BlaBranch
 git push :orign/remotes/Foobar_Für_mich 

Wir sehen hier „git push :“-Befehle. Damit werden genau diese Branches auf dem betreffenden remote (hier „origin“) gelöscht. Es ist die Kurzform von erst lokal im remote löschen mit -D (delete) und dann ein push -f (force). Also mit ausreichenden Berechtigungen ausgeführt, macht dieses Skript sauber.

Das Skript:


# Sucht nach stale git branches. d.h. älter als TTL Tage oder mehr als $MaxBehind hinter $RefBranch, was meist master ist.
# Ausführen in einem Git-Repo, wo Kommandos wie `git refs` etc. verfügbar sind. Ausgabe umleiten
# Es wird also nichts gefährliches gemacht in diesem Skript. Es wird auf Konsole
# eine Reihe git push :$branch -Befehle generiert, die in eine Datei umgeleitet und dann ausgeführt werden müssen
# Benutzung
# ..\$0 > kille_sie.ps1
# > .\kille_sie.ps2
# Diese datei als UTF-8 BOM speichern, Ausgabedatei ist es ebenfalls, weil Zeile 13. Damit funzen auch Branches wie "für dich"

#$PSDefaultParameterValues['*:Encoding'] = 'utf8'
[Console]::OutputEncoding = [System.Text.UTF8Encoding]::new($false)
#$OutputEncoding='utf8'
$TTL = 80 #days
$MaxBehind = 444 #behind to $RefBranch
$RefBranch = "remotes/origin/master"
$borderTime = (Get-Date).AddDays(-$TTL)
git fetch origin
$branches = git branch -a --format '%(refname:lstrip=1)' 

$remoteBranches = $branches | Where-Object {$_ -like '*remotes/origin/*'} 

$remoteBranches = $remoteBranches | Where-Object { ($_ -notlike 'remotes/origin/HEAD*') `
                                              -and ($_ -ne $RefBranch) `
											  -and ($_ -notlike 'remotes/origin/keep/*') `
											  -and ($_ -notlike 'remotes/origin/release/*') `
											  -and ($_ -notlike 'remotes/origin/releases/*') `
											  } 
											
foreach($branch in $remoteBranches)
{
    $branchName = ($branch.Split('/', 3))[2]
    $branchSHA = git rev-parse $branch
    $branchLastUpdate = [DateTime]::Parse($(git show -s --format=%ci $branchSHA))
	$branchBehindAhead = $(git rev-list --left-right --count $RefBranch...$branch)
	$branchBehind = [int]::Parse($branchBehindAhead.Split(9)[0])   # 9 is a tab

	# Bedingung
    if($branchLastUpdate -lt $borderTime -or $branchBehind -gt $MaxBehind)
    {
		Write-Host "Stale Branch:  $branchLastUpdate <<$branchBehind - '$branchName'"
        Write-Output "git push origin "":$branchName"""
    }
}
Software ist vorbei

Ich nehme mal Bezug auf das Papier ‚Software is over‘.

Es ist schon erstaunlich wie ohne viel Aufhebens mit einem LLM im Kürze ganze Programme oder Webseiten nachprogrammiert werden können. Man möchte also glauben, Software ist etwas beliebiges geworden. Sofort verfügbar in genau meiner gewünschten Ausprägung. So scheint es. Dank Reverse Engineer All und den aus dem Nichts entstandenen Apps von ArtCraft scheint kein Stein mehr auf dem anderen zu stehen. Wahnsinn.

Ganz so drastisch ist es nicht. Es zeigt sich, dass die Anwendugen von ArtCraft noch nicht in allen Details so funktionieren, wie die originale, die zweifelsohne nachgeahmt sind (angeblich ja eine Clean room implementierung ohne ghidra etc). Ist aber auch klar, denn so eine Anwendung ist ja fast unendlich komplex. In jedem Zustand müssten alle Tools in jeder Reihenfolge und mit allen Parameterkombinationen ausprobiert werden. Was natürlich nicht geht. Aber auch das wäre wieder so ein Teil, was KI ganz gut kann…. na jedenfalls sind sie erstaunlich nachgeahmt. Und da ist schon mal der erste Punkt: Das eigentliche Grips steckt darin, wie die Anwendung aufgebaut ist, und wie sie sinnvoll ihre Funktionen kombiniert und welche sie (wann) anbietet. Da stecken eben zum teil 30J Erfahrung drin. Das ist die eigentliche Raubkopie in diesem Fall. Die Idee, das Konzept. Gleichwohl kann ich mir nicht das Recht reservieren, als einziger eine Rechenanwendung mit Zellen zu haben und keiner darf etwas ähnliches machen! Der zweite Punkt ist, dass die Software Bugs hat – die werden zwar weg gehen, aber werfen wir mal einen Blick auf die Leute, die mit Vibe-Coding mal schnell eine App entwickeln. Die wird eher unkommod zu bedienen sein. Sie wird Bugs und Unschöhheiten enthalten. Hingegen ist eine von vielen Entwicklern und lange gepflegte Software stimmig und mit wenigen Bugs versehen.

Ich habe dazu eine nette Analogie: Man nehme eine Steppe mit Wildpferden. Die Wildpferde „entstehen“ einfach so. Man kann sich also jederzeit eines „schnappen“. Allerdings wird das Pferd Krankheiten und Eigenheiten haben. Man muss es erst Einreiten etc. Dagegen könnte ich aber auch zu einem Pferdezüchter gehen. Der hat für mich ein gesundes, schönes und braves Pferd, mit dem ich gleich reiten kann. Dafür will er aber Geld, denn es hat ihn auch viel Aufwand gekostet.

ZUGFeRD und XRechnung für Dolibarr

Wer ein kleines Unternehmen fürt, braucht (!) ein ERP-System. Ja, viele schreiben Rechnungen mit Textverarbeitung oder Tabellenkalkulation oder TeX. Aber sein wir Ehrlich – das ist am Ende immer Gefrickel, wird nicht GoDB-Konform und die Übersicht (Mahnwesen, Summen, Salden) fehlt quasi ganz. Und mit der Pflicht zu ZugFeRd (ab 1.1.2027) ist es damit endgültig aus.
Man muss jetzt nicht zu großen Kalibern oder Abomodellen greifen. Bei mir läuft seit Jahren Dolibarr (ein Open Source ERP-System) gut und tut seinen Dienst. Bei mir ist es eine dedizierte VM. Man könnte es aber auch „lokal“ im Container betreiben.

Wie dem auch sei. Dolibarr kann bei mir Rechnungen und Offene Posten verwalten. Was fehlt, ist bislang XRechnung und ZUGFeRD. So habe ich mich hingesetzt und habe eine Erweiterung geschrieben, die dieses Feature bei Dolibarr nachrüstet. Wenige Dateien, unabhängig, etwas KI-Hilfe und schon gab es neue Buttons in der Rechnungs-View und die neuartigen PDF- und XML-Dateien lassen sich auch als E-Mail-Anhang mitschicken.

Hier ist das Codeberg-Projekt

Ich möchte euch dieses tatsächlich ans Herzen legen und empfehlen. Hier ist der Quellcode. Die ZIP-Datei muss man gemäß der Readme in die Installation von Dolibarr unter /custom ablegen und schon kann man es aktivieren.

In Kürze gibt es noch ein paar Bilder dazu

Meine Thunderbird Add-Ons

Auch Thunderbird – ein recht vollständiger IMAP-Client – braucht noch einige Add-Ons, um gut benutzbar oder nützlicher zu sein.

Hier mal meine Liste, die ich so üblicherweise habe. Voraus: CardBook ist inzwischen Teil von Thunderbird und muss gar nicht nachinstalliert werden, kann aber noch zusätzlich erweitert werden.

  • *cloud : Große Anhänge auf NextCloud zwischenhosten – auf der eigenen
  • AutoArchiveReloaded : Archiviert E-Mails nach einem gesetzten Zeitraum automatisch mit dem üblichen Archivieren-Befehl
  • CardBook : Der CardDAV-Client, den man braucht insb. als Client zu NextCloud
  • CollectAddresses : Sammelt alle Adressen und speichert sie in einem Adressbuch
  • Outlook/Team Appointments : Die kryptischen Outlook-Termine extrahieren und darstsellen
  • ReplyAsOriginalRecipientUp : Bei Antworten an, gleich die originale Absenderadresse nehmen. Dann nützlich, wenn man eine Domäne bsp.de hat und jedem Unternehmen eine eigene E-Mail gibt. Dann sollte man tunlichst auch die Antwort wieder von der E-Mail-Adresse geben. Das macht dieses Add-On.
  • DKIM Verifier : Zeigt einen Indikator, ob der Absender auch von der Absenderdomäne erlaubt ist. Verifiziert durch den DKIM-Schlüssel im DNS
  • Simple Mail Redirection : Erlaubt das Umleiten von Mails. Eigentlich ein Befehl für Server, kann hier der Client so tun, als ob die E-Mail nicht weitergeleitet, sondern nur übe Umwege zum eigentlichen Empfänger kam.
  • Zeig’s Mir! (LookOut) : vermutlich überflüssig, dekodiert dieses Add-On winmail.dat, was ältere Outlooks als Termine versenden.

Was meint Ihr, welches Add-On ist für Euch unverzichtbar. Schreibt es in die Kommentare!

Mit opencode Agenten parallel nutzen

Ich bin gerade verstärkt in meinem Lieblingstool opencode unterwegs. Zuletzt habe ich mich tiefer mit Subagents beschäftigt und wie man die parallel und sequentiell einsetzt. Und daraus gleich ein Video gemacht. Wer sich also vom Erklärbär Rob zeigen lassen will, wie man das effektiv einsetzt, immer zu: https://youtu.be/5BqGA7wuRAM

Was ist Intelligenz

Die Definition von Inelligenz war schon immer herausfordernd und ist abschließend nicht geklärt. Ich will dennoch einen Versuch starten. Da ich momentan viel mit KI spiele und parallel eine kleine NI beobachte, wie sie ihre Umwelt erfasst und Sprache erlernt, ziehe ich so meine Schlüsse. Auch OpenClaw hat mich zuletzt inspiriert.

Also was ist Intelligenz?
Ich würde sagen, das ist so: LLMs machen ja schon eine recht gute Figur. Es sind statistische, deterministische Automaten, die allerdings chaotisch reagieren. Und dennoch damiteine statistische Vorhersage über den wahrscheinlichsten Ausgang der Tokenfolge machent. Damit wirkt die Ausgabe zwar undeterministisch/zufällig aber intelligent. Dennoch gehört zu Intelligenz viel mehr. Nämlich Vision und Abstraktion. Als menschliche Intelligenz bin ich den ganzen Tag Reizen ausgesetzt. Mein neuronales Neztwerk läuft quasi pausenlos. Einige dieser Reize lösen bei mir ein Begehren aus, eine Vision, was ich haben will, oder wohin ich mich entwickeln will. Das ist ein Teil, den wir aktuell alleine haben. Das hat sicherlich auch mit Gefühlen zu tun.
Intelligenz ist also in der Rolle (mit der Vision) mehrere Vorhersagen zur Erreichung eines Ziels zu machen und die beste (wenigste Kosten, Zielmaximierung) herauszusuchen und umzusetzen.

Ablauf

Nehmen wir an, ich habe eine Banane gesehen und einen entsprechenden Bedarf. Dann mache ich eine Wegplanung und entdecke einen Graben zwischen mir und der Banane. Meine Vorhersage ist: Der Graben ist so tief, da fällst du hinein und bist tot. Weiter gibt es die Vorhersage: Wenn ich rechtzeitig springe, komme ich über den Graben oder ich lasse es, dann erreiche ich nichts. Das sind die Vorhersage in der Rolle „Ich will die Banane“. Damit (und der Vision der Selbsterhaltung) werde ich mich zu Laufen und Springen entscheiden und mein Ziel erreichen. Es könnte sich aber auch die Rolle geben, die sagt „bringe dich um“, dann wird die Vorhersage „Ohne Springen fällst du“ die bevorzugte sein.

Ja, etwas einfach. Aber das sind m. E. die Komponenten für intelligentes Handeln. Die Vision und die rollenbezogenen Vorhersagen aus der Erfahrung/Training. Es ist also das Zusammenspiel mehrerer Komponenten (Neuronaler Netze/Bereiche). Es kommen ja in aller Regel noch Dinge hinzu wie Angst oder eine Fehlerüberprüfung („Moment mal, kann das stimmen?“). Also weitere Gegenspieler, die alles Beeinflussen. Dies ist unabhängig davon, ob ich meine Vorhersage aus statistischer Auswertung habe oder ob ich durch Abstraktion und Anwendung mein Ergebnis habe. Jedoch ist diese Abstraktion des Problems das, was ein Transformer-Modell (LLM) bislang nicht kann.

Wie ich OpenEMS zum laufen brachte

Hier mal eher ein Notitzblatt/Reminder, wie man OpenEMS zum laufen bekommt, da die Anleitung bei denen eher so mau ist. Oder wie beim Matheprof. „Das steht doch im Skript“… „ja, irgendwie 22 Seiten davor in einem Nebensatz im dritten Absatz links…. und ohne Beispiel“. Ja also hier mal was ich tat:

Aufbau

Zunächst zum Aufbau von OpenEMS. Es gibt die Teile:

  • Edge
  • Backend
  • UI
  • Zeitreihendatenbank/Influxdb

Man muss sich das so vorstellen, dass es mehrere Edge-EMS gibt. Das sind die lauffähigen Instanzen, die vor Ort sind und die eigentliche Arbeit des Messens und Steuerns machen. Die Rapportieren an das Backend (z.b. Messdaten und Stati)

Das Backend macht die Koordiation und Authentifizierung (hier Metadata genannt) und schreibt die Messdaten in eine Zeitreihendatenbank – hier verwendent: Influxdb

Zeitreihendatenbank/Influxdb: Die speichert die Messdaten und vergisst unwichtige Details.

UI: Die Grafishe Oberfläche. Das UI ist in node geschrieben und kann sowohl Edge als auch Backend betreuen. Typischerweise wird es zusammen mit ZeitDB und Backend auf einem Server im Internet erreichbar gehostet. In der Backendversion sieht man das Backend und alle verbunden Edge-Instanzen und kann dort „rüberwechseln“. Dabei mus keine eigene UI-Instanz per Edge laufen.

Deploy

Ich wollte ein docker deployment machen, damit man die Version schnell hochhauen kann. Ohne große Veränderung am Hostsystem. Und mit Renovate (Dienst) dann immer Up2Date ist. Einfach ein Redeploy machen.

Um nun InfluxDB, Backend und UI gemeinsam zu starten, hat sich diese docker-compose.yml-Datei bewährt. (docker label :develop kann durch :latest ersetzt werden)

services:
  openems_backend:
    image: openems/backend:develop
    container_name: openems_backend
    hostname: openems_backend
    restart: unless-stopped
    volumes:
      - openems-backend-conf:/var/opt/openems/config:rw
      - openems-backend-data:/var/opt/openems/data:rw
    ports:
      - 8079:8079 # Apache-Felix
      - 8081:8081 # Edge-Websocket
      - 8082:8082 # UI-Websocket

  openems-ui:
    image: openems/ui-backend:develop
    container_name: openems_ui
    hostname: openems_ui
    restart: unless-stopped
    volumes:
      - openems-ui-conf:/etc/nginx:rw
      - openems-ui-log:/var/log/nginx:rw
    environment:
      - UI_WEBSOCKET=ws://<publichost>:8082
    ports:
      - 1080:80
      - 1443:443

  openems_influxdb:
    image: influxdb:alpine
    container_name: openems_influxdb
    hostname: openems_influxdb
    restart: unless-stopped
    volumes:
      - openems-influxdb:/var/lib/influxdb2:rw
    ports:
      - 8086:8086

volumes:
  openems-backend-conf:
  openems-backend-data:
  openems-ui-conf:
  openems-ui-log:  
  openems-influxdb:

Natürlich wird man im Produktiven dann z.B. nginx als Reverse-Proxy davor hauen oder anderweitig TLS aktivieren.

Befehle:

# starten mit
docker compose up (-d)
# stoppen
docker compose down 

# restart
docker compose restart 

# status
docker ps

# backend logs anschauen
docker logs openems_backend -f

# shell
docker exec -it openems_backend bash

Einrichten InfluxDB

Nachdem gestartet wurde, muss das Passwort und der API-Key (Notieren) von Influxdb gesetzt werden:

docker exec openems_influxdb influx setup \
  --username openems \
  --password WKeuIhl0deIJjrjoY62M \
  --org openems.io \
  --bucket openems \
  --force

docker exec openems_influxdb influx auth list

Nun laufen einige Sachen

  • Influxdb und Webobefläche: http://publichost:8086 mit openems:WKeuIhl0deIJjrjoY62M
  • Backend ist erreichbar als Apache felix: http://publichost:8079/system/console mit admin:admin
  • Backend hat einen Websocket exponiert: ws://publichost:8081
  • UI ist erreichbar via http://publichost:8086/ ohne auth (irgendwas eingeben)

Das Problem ist erst mal, dass das Backend in einen Fehler läuft. Was man einem nicht sagt, ist, dass man eine metadata.conf-Datei braucht. Oder für den Test halt nicht braucht.
WARN [end.metadata.file.MetadataFile] [Metadata.File] Unable to read file [/var/opt/openems/metadata.json]: /var/opt/openems/metadata.json (No such file or directory)

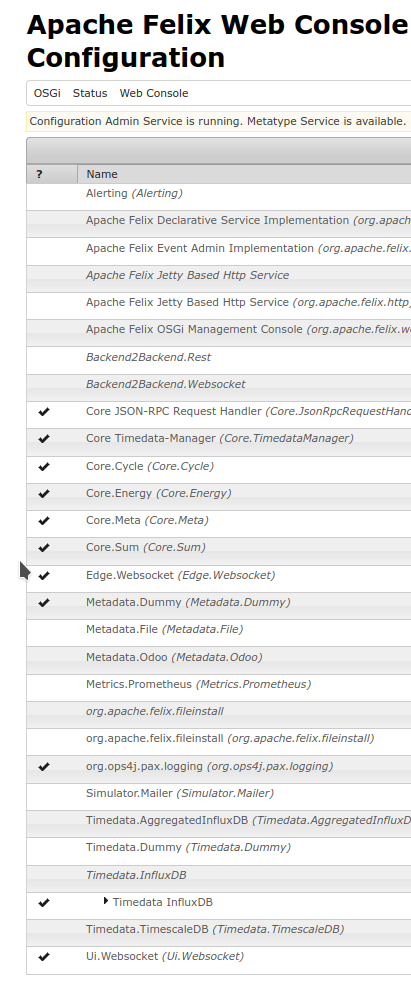
Das löst man, indem man beim Backend den Dummy-Metadata-Service konfiguriert: Gehe auf das Apache Felix des Backends (http://publichost:8079/system/console ) und kille Metadata.File und Hinzufüge Metadata.Dummy (keine Konfig erforderlich) Wenn es so aussieht, geht’s erst mal:

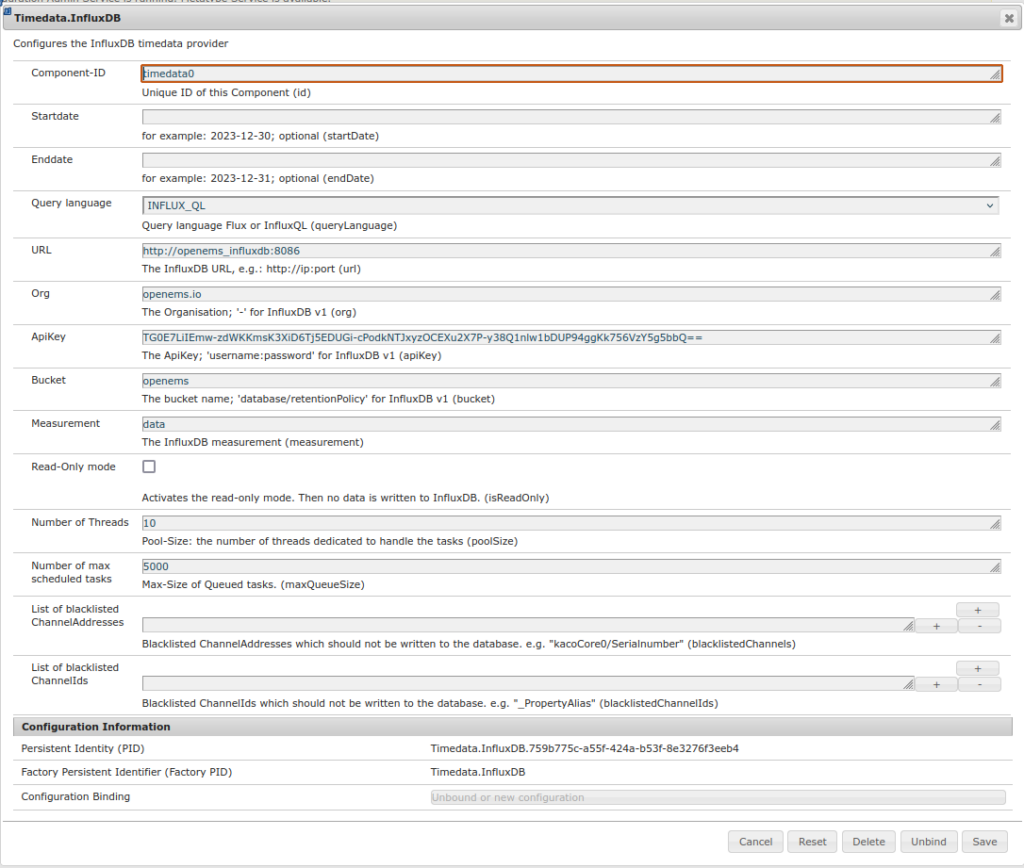
Timedata.InfluxDB sollte in etwa so aussehen:

Der API-Key ist der, der weiter oben bei Einrichten InfluxDB ausgespuckt wurde. org und Bucket festlegen. Ansonsten kann man die influxdb Doker-Intern erreichen!

Zum vollständigen Glück fehlt noch ein wenig Konfig im Backend und eine Edge-Instanz und deren Konfig.

Edge

Um eine Edge-Instanz zu haben, habe ich mir ein Entwicklersystem eingerichtet und es lokal laufen lassen. Damit war ich dann zumindest mal auf einem anderen Host als da wo der Docker läuft. Macht es etwas realitätsnäher. Man kann die edge sicher auch als docker laufen lassen. Auf jeden Fall muss die irgendwie mit dem Backend verbunden werden und weiter Konfiguriert. Verbindung zum Backend gibt’s hier; nächstes Kapitel verweist auf weitere Konfigurationen, die in der Online-Doku sind, die man anwenden sollte auf der Edge.

Man geht also auf das Apache Felix der Edge-Instanz. Bei mir ist das (wegen Entwicklersystem) http://localhost:8080/system/console/configMgr PW: admin:admin
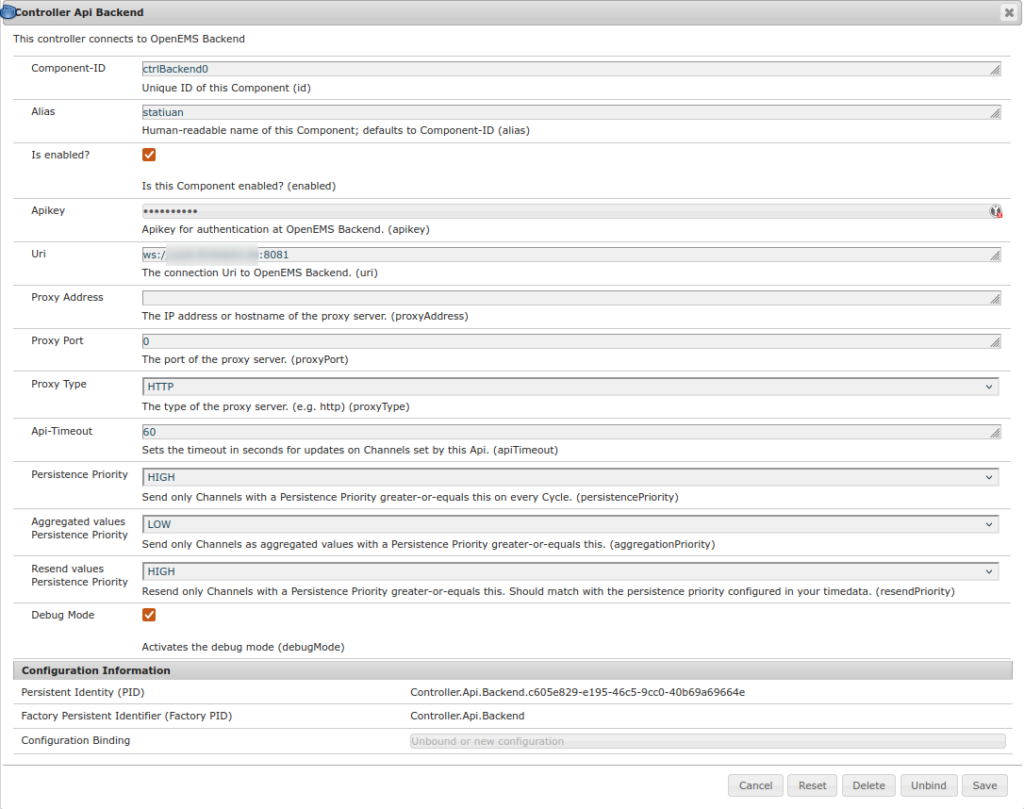
Hier Konfiguriere ich den Controller Api Backend wie folgt:

Wesentlich ist die WS-Url zu dem global auflösenden Namen des Backends. Wie durch Docker compose festgelegt ist es auf Port 8081. Da wir Metadata.Dummy einsetzen, ist der API-Key egal. Ebenso der alias.

Konfig des Backends und Edges

Edge braucht noch einige Komponenten, um ein wenig „was zu tun“.

Konfigurieren wie hier: https://openems.github.io/openems.io/openems/latest/gettingstarted.html#_configure_openems_edge

und hier: https://community.openems.io/t/step-by-step-guide-for-beginners-setting-up-openems-simulation-configuration-is-this-correct/3197

Test

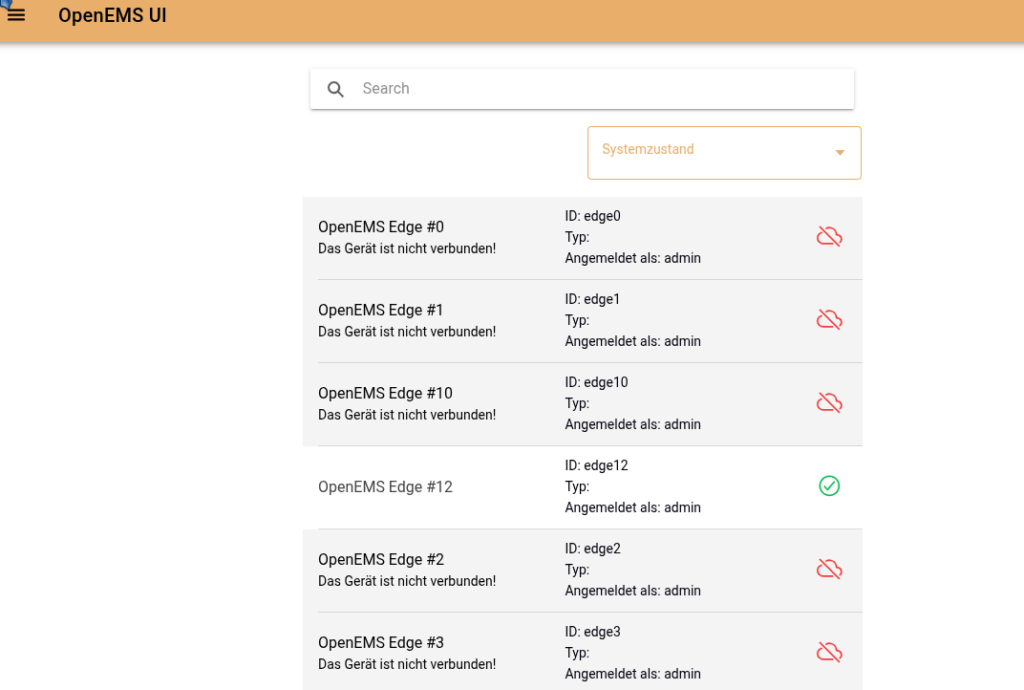
Nun kann man auf die UI gehen: http://publichost:8086/ Nutzername ist wie gesagt egal (weil Metadata.Dummy) und dort sollte nun die Edge-Instanz auftauchen, die man gestartet hat.

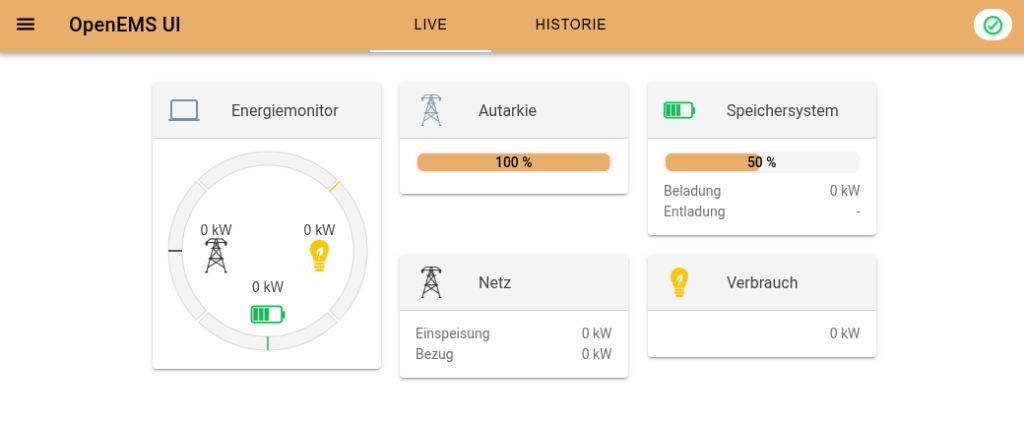
drinnen sieht es etwa so aus (je nach Simulation mehr)

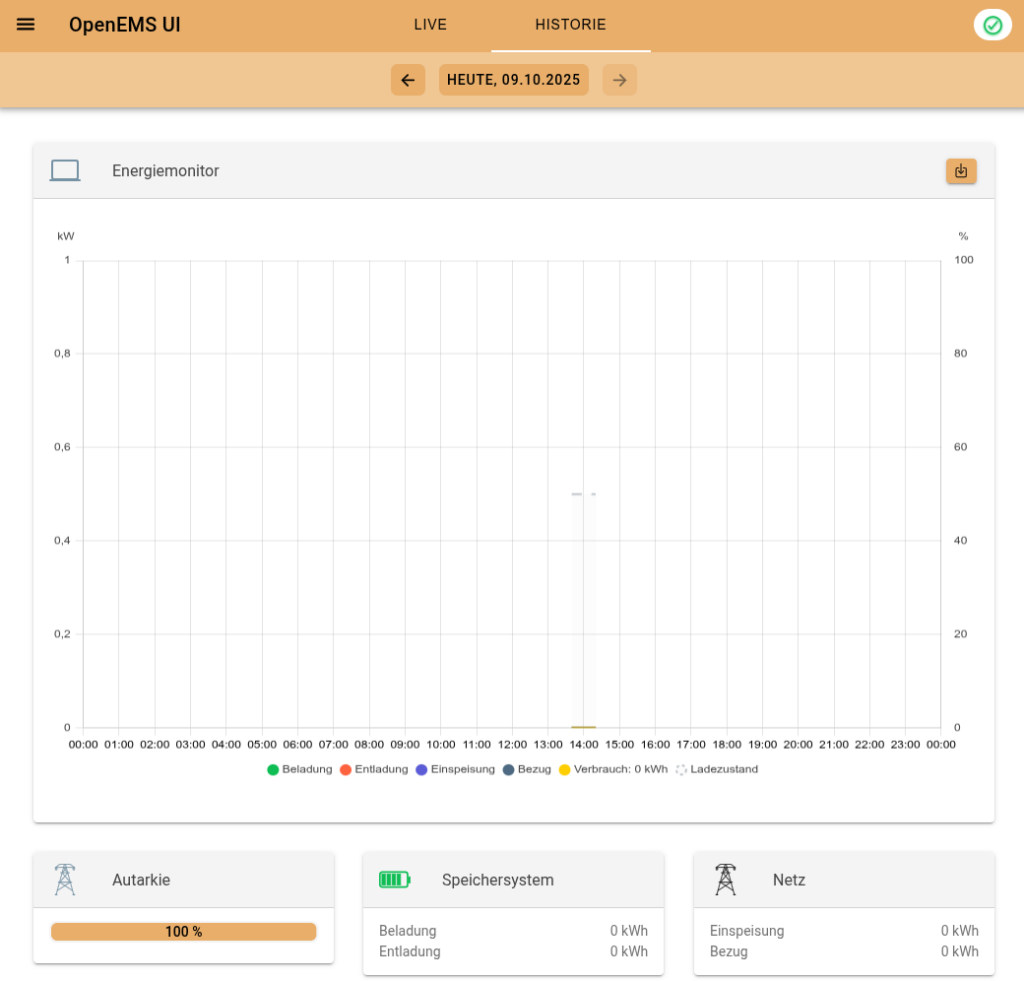
In die Historie kommt man auch (da man ja das Backend hat):

Wireguard auf einfach

Wireguard, dieses VPN kann einen ganz schön beschäftigen. Zunächst vermutet man die Funktionalität anders gelagert, ehe man später herausfindet, wie es ist und es korrekt macht. Um diesen Weg zu vereinfachen, habe ich mir gedacht, dass ich mal einige klärende Sätze los werde und meine paar Skripte dazu gebe, mit denen ich das Ganze Management ziemlich einfach gestaltet habe.

Wireguard das Wesen

Wireguard ist toll simpel und doch in der Konfiguration sehr komplex. Zumindest, wenn man unbedarft ran geht, versteht man erst mal nicht was eine gute Konfiguration ist und welche Randparameter einzuhalten sind.

Erkenntnis

Die Erkenntnisse dazu sind:

  • Wireguard ist eine Punkt-zu-Punkt VPN-Verbindung. Das heißt, es werden keine Netze verbunden sondern immer nur zwei Interfaces miteinander.
  • Daraus leitet sich die Folge ab, dass der Verkehr also über das einzurichtende Zwischennetz geroutet wird.
  • Ein Paket wandert also von einem Netz durch den Forwarder in das VPN-Netz und auf der anderen Seite in das ferne Netz, wieder durch den Forwarder des VPN-Routers.
  • Wireguard kann nur immer einen Gegner pro Interface und Port haben
  • Man muss also viele kleine Netze anlegen und jeweils eigene Ports nutzen
  • Es gibt Konfigs für Clients und für Server
  • Die Schlüssel darin sind anitsymmetrisch darin verteilt (perfekt zur Automatisierung)
  • Die IP-Adressen sind ebenfalls antisymmetrisch
  • Andere Dinge sind gleich oder nur hier oder dort anzuwenden

Anwendungsfall

Ich beschränke mich hier auf den Anwendungsfall Netzkopplung mit einem zentralen Router. Sprich es gibt mehrere Clients und diese bringen entweder sich selbst oder zusätzlich ein ganzes Netz herein. Ab da funktioniert das Routing auch zwischen den Netzen (Voraussetzung sind allerdings gepflegte statische Routen auf dem Standardgateway der gekoppelten Netze = war immer so).

Skripte

Dieses wurde berücksichtigt, um die folgenden Skripte zu erstellen. Als einzigstes Ding muss man sich einen Namen ausdenken für den neuen Client. Und natürlich muss die dabei entstandene Client-Konfig auf den Client verbracht werden.

Die Skripte sind dazu gedacht, im /etc/wireguard-Verzeichnis zu residieren und dort lokal Änderungen zu machen und als root systemctl aufzurufen.

Als Infrastruktur kommt ein _-Verzeihnis mit. Darin sind die Vorlagedateien für die Server- und Client-Konfig drin mit Platzhalter. Das mk_-client.sh-Skript macht dann mit sed einen Such- und Ersetzenlauf. Weiterhin sind in diesem Verzeichnis .txt-Dateien, die die jeweils zuletzt vergebenene IP/Port enthält. Diese Dateien sind bei Bedarf/zu Beginn zu pflegen.

_/last-ip.txt

10.254.0.4

Anpassen bei Bedarf – das 10er Netz scheint gut. Es wird immer 2 hochgezählt, da ja immer Point-to-Point zwei Adressen gebraucht werden.

_/last-port.txt
14264

Hier wird der letzte Port gemerkt und weiter hochgezählt. alles uter 64k ist gut.

_/client.conf
[Interface]
# set address to next address
Address = :CLIENT_IP:/32
PrivateKey = :CLIENT_KEY:
#DNS = 8.8.8.8

[Peer]
PublicKey = :SERVER_PUB_KEY:
Endpoint = :SERVER_ADDRESS:::PORT:
PresharedKey = :PSK:
# Route only vpn trafic through vpn
AllowedIPs = 10.254.0.0/24, 192.168.88.0/24, 192.168.22.0/24
# Route ALL traffic through vpn
#AllowedIPs = 0.0.0.0/0
PersistentKeepalive = 21ds

Hier sind Platzhalter mit :PLH:-Notation drin, die beim Erzeugen ersetzt werden. Bei AllowedIPs kann der geneigte Admin all seine Netze hinzufügen. Da dieser Teil kopiert wird, müssen alle erstellten client.confs angepasst werden, wenn neue Netze hinzukommen. In diesem Fall sind es /24-Netze.

_/server.conf
[Interface]
Address = :SERVER_IP:/32
MTU = 1420
ListenPort = :PORT:
PrivateKey = :SERVER_KEY:
PostUp = /etc/wireguard/wg-iptables-updown.sh :IF_NAME: up
PostDown = /etc/wireguard/wg-iptables-updown.sh :IF_NAME: down

[Peer]
PublicKey = :CLIENT_PUB_KEY:
PresharedKey = :PSK:
AllowedIPs = :CLIENT_IP:/32

Dies ist die Vorlage für neue Server-Konfigs. Interessant dabei, dass die eigene und Gegen-IP des VPN-Netzes /32-Adressen sind. Also genau je eine Adresse. Zudem ist hier der wg-iptables-updown.sh – Aufruf drin, der das Routing auf dem zentralen Router aktualisiert und entsprechende Forwarding-Regeln einfügt oder entfernt. Diese Datei ist auch mit dabei. Siehe hier:

wg-iptables-updown.sh
#!/bin/sh

iptables="/usr/sbin/iptables"

if [ -z "$1" ]; then
	echo "No interface!"
	echo "Usage: $0 [interface] [action]"
	exit 0

fi

if [ -z "$2" ]; then
	echo "No action!"
	echo "Usage: $0 [interface] [action]"
	echo "Actions:"
	echo "* up"
	echo "* down"
	exit 0

elif [ "$2" = "up" ]; then
	action="-A"

elif [ "$2" = "down" ]; then
	action="-D"

else
	echo "Unknown action!"
	echo "Usage: $0 [interface] [action]"
	echo "Actions:"
	echo "* up"
	echo "* down"
	exit 0

fi

$iptables $action FORWARD -i $1 -j ACCEPT
$iptables $action FORWARD -o $1 -j ACCEPT

Hauptteil

Den Hauptteil bilden die zwei Skripte mk-client.sh und rm-client.sh

Damit wird ein neuer VPN-Entpunkt hinzugefügt bzw entfernt.

mk-client.sh

Einzig der Name für diese Verbindung wird als Parameter gebraucht. Es wird dafür ein öffentlicher und Privater Schlüssel und ein neues Geheimnis ausgewürfelt und in entsprechenden Dateien im ./clients/-Verzeichnis gespeichert. Von dort kann man die Dateien (eigentlich nur die .cofig) für den Client extrahieren und weitergeben. Die Server-.config wird im /etc/wireguard-Verzeichnis abgelegt und ist somit direkt verfügbar. Das wird auch gleich genutzt und wireguard damit konfiguriert. Sowohl die client- als auch die server-Konfig sind Kopien der Vorlagedateien. Die Platzhalter (wie z.B. Schlüssel und IPs) werden durch sed-Aufrufe ersetzt. So einfach.
Am Ende kommt noch eine Frage, ob man denn die Konfig gleich in systemd und beim Systemstart aktivieren möchte.

#!/bin/bash
VPN_HOST=vpn.flinkebits.de

if [ $# -eq 0 ]
then
	echo "must pass a client name as an arg: mk-client.sh new-client"
else
	umask 077
	echo "Creating client config for: $1"
	mkdir -p clients/$1
	wg genkey | tee clients/$1/$1.priv | wg pubkey > clients/$1/$1.pub
	CLIENT_KEY=$(cat clients/$1/$1.priv)
	CLIENT_PUB_KEY=$(cat clients/$1/$1.pub)
        infix=$(cat _/last-ip.txt | tr "." " " | awk '{print $4}')
	ips="10.254.0."$(expr $infix + 1)
	ipc="10.254.0."$(expr $infix + 2)
        lastport=$(cat _/last-port.txt)
        port=$(expr $lastport + 1)
	wg genpsk > clients/$1/$1.psk
	PSK=$(cat clients/$1/$1.psk)

	wg genkey | tee clients/$1/server.priv | wg pubkey > clients/$1/server.pub
        SERVER_KEY=$(cat clients/$1/server.priv)
        SERVER_PUB_KEY=$(cat clients/$1/server.pub)


  cat _/server.conf | sed -e 's|:PSK:|'"$PSK"'|' | sed -e 's/:SERVER_IP:/'"$ips"'/' | sed -e 's/:CLIENT_IP:/'"$ipc"'/' | sed -e 's|:SERVER_KEY:|'"$SERVER_KEY"'|' | sed -e 's|:CLIENT_PUB_KEY:|'"$CLIENT_PUB_KEY"'|' | sed -e 's|:PORT:|'"$port"'|' | sed -e 's|:IF_NAME:|'"wg-$1"'|' > wg-$1.conf

  cat _/client.conf | sed -e 's|:PSK:|'"$PSK"'|' | sed -e 's/:CLIENT_IP:/'"$ipc"'/' | sed -e 's|:CLIENT_KEY:|'"$CLIENT_KEY"'|' | sed -e 's|:SERVER_PUB_KEY:|'"$SERVER_PUB_KEY"'|' | sed -e 's|:PORT:|'"$port"'|' | sed -e 's|:SERVER_ADDRESS:|'"$VPN_HOST"'|' > clients/$1/$1.conf

	echo "Erzeuge in clients/$1 $1.priv, $1.pub, server.priv, server.pub"
	echo "Erzeuge clients/$1/$1.conf"
	echo "Erzeuge wg-$1.conf"
	echo "Speichere zuletzt verwendete IP, Port: $ipc : $port"
	echo $ipc > _/last-ip.txt
	echo $port > _/last-port.txt
	echo "Konfig fertig!"

	read -p "Aktivieren von $1 in systemctl? (y/n) " yn

	case $yn in 
		[yY] ) echo ok, we will proceed;
			systemctl enable wg-quick@wg-$1.service
			systemctl start wg-quick@wg-$1
			;;
		* ) echo exiting...;
		exit;;
	esac
fi

rm-client.sh

Die rm-client macht es recht einfach. Fährt das interface ordentlich runter, entfernt es aus systemd und löscht die Dateien:

#!/bin/bash

if [ $# -eq 0 ]
then
        echo "must pass a client name as an arg: $0 aclient"
else
	wg-quick down wg-$1
	systemctl stop wg-quick@wg-$1
	systemctl disable wg-quick@wg-$1.service
	rm -rfv "/etc/wireguard/clients/$1/"
	rm -v "/etc/wireguard/wg-$1.conf"
fi

GIT-Repo

Das Ganze könnt ihr auch in einem Git-Repo auf einmal herunterladen und in euer /etc/wireguard-Vz werfen. https://github.com/ChaosChemnitz/Wireguard-einfach

Lodgify per API abfragen

Seit einiger Zeit bin ich mit meiner Familie dabei, eine Ferienwohnung zu betreiben. Das ist eher aus der Not heraus geworden, denn die Gewerbeeinheit ließ sich sonst nicht vermieten. Ergo musste man halt mal selbst ran an die Sache.

Ich will hier gar nicht abschweifen in die Untiefen der Ferienwohnungen und deren Implikationen. Nur so viel: Ohne Buchungsportale geht heute quasi nix und wer nicht mindestens auf AirBnB und booking unterwegs ist, bekommt nichts vom Kuchen ab. Doch wie verwaltet man die mindestens zwei „Kanäle“? Man braucht einen „Channelmanager“. Davon gibt es in der echt recht korrupten Hoteleriebranche viele. Sie überbieten sich meist eher darin, ein möglichst großes Stück von deinem verdienten Geld mit abzugreifen – mit Prozenten etc.

Am Ende entscheidet man sich für irgendwas, was mit halbwegs normalen Kosten und Features wie dynamische Preise und (sowieso) Synchronisation der Kalender aufwartet. Bei uns ist das, wie auch immer, Lodgify geworden.

Aber jetzt kommts: Die bieten zwar einen Basistarif (der für uns die richtige Mischung ist), aber die echten Basisfeatures bieten sie halt da nicht an. Edit: Wundere mich gerade, warum überhaupt Kanäle buchbar angebunden sind??! Also was fehlt: Es gibt nicht mal eine absolute Basisübersicht über die Buchungen des aktuellen Monats und die Einnahmen. Dummerweise sollte man diese Daten haben, wenn man die lokalen Steuern bezahlen will. Aber dieses Feature gibt es auch nicht im Pro-Plan, sondern nur im Ultra-Plan. OKOK, ist wohl absolut ultra, dass ich mal so eine Übersicht als Tabelle benötige… nun ja.

Zum Glück aber gibt es ein Integrations-API. Damit konnte ich mit doch sehr überschaubarem Aufwand meine Buchungen abrufen. Hier mal mein Vorschlag, das in Python zu machen. Viel Spaß beim nachmachen:

Pythonimplementierung:

import requests
import pandas as pd
from datetime import datetime

# ggf installieren:
# pip install requests pandas openpyxl

# API-Konfiguration
API_KEY = "<bitte füllen>"  # Ersetze mit deinem Lodgify API-Key
BASE_URL = "https://api.lodgify.com/v2/reservations/bookings"

# Zeitrahmen für die Abfrage (optional)
params = {
    "size":100,
    "includeExternal": True,
    "stayFilter": "Historic",
    "trash": False
}

# API-Anfrage mit korrektem X-ApiKey-Header
headers = {
    "X-ApiKey": API_KEY,
    "Accept-Language": "de",
    "accept": "application/json"
}

try:
    print("Starte API-Anfrage...")
    response = requests.get(BASE_URL, headers=headers, params=params, timeout=10)
    response.raise_for_status()  # Löst HTTPError für 4xx/5xx Statuscodes aus
    data = response.json()

    # Prüfe, ob die Antwort die erwartete Struktur hat
    if not isinstance(data, dict) or "items" not in data:
        raise ValueError("Ungültige API-Antwort: JSON element 'items' nicht gefunden.")

except requests.exceptions.HTTPError as errh:
    print(f"HTTP-Fehler: {errh}")
    print(f"Statuscode: {response.status_code}")
    print(f"Antwort: {response.text}")
    exit(1)
except requests.exceptions.ConnectionError as errc:
    print(f"Verbindungsfehler: {errc}")
    exit(1)
except requests.exceptions.Timeout as errt:
    print(f"Timeout-Fehler: {errt}")
    exit(1)
except requests.exceptions.RequestException as err:
    print(f"Anfragefehler: {err}")
    exit(1)
except ValueError as ve:
    print(f"Datenfehler: {ve}")
    exit(1)

# Daten aufbereiten
bookings = []
for booking in data.get("items", []):
    arrival = booking.get("arrival")
    departure = booking.get("departure")
    rooms = booking.get("rooms", [])
    total_amount = booking.get("total_amount", 0)
    guest = booking.get("guest")

    # Anzahl der Tage berechnen
    if arrival and departure:
        try:
            arrival_date = datetime.strptime(arrival, "%Y-%m-%d")
            departure_date = datetime.strptime(departure, "%Y-%m-%d")
            num_days = (departure_date - arrival_date).days
        except ValueError:
            num_days = 0
    else:
        num_days = 0

    # Gast-Informationen aus dem ersten Zimmer extrahieren
    adults = 0
    children = 0
    people = 0
    if rooms:
        guest_breakdown = rooms[0].get("guest_breakdown", {})
        adults = guest_breakdown.get("adults", 0)
        children = guest_breakdown.get("children", 0)
        people = rooms[0].get("people", 0)

    bookings.append({
        "Buchungs-ID": booking.get("id"),
        "Gastname": guest.get("name"),
        "Startdatum": arrival,
        "Enddatum": departure,
        "Anzahl Tage": num_days,
        "Anzahl Erwachsene": adults,
        "Anzahl Kinder": children,
        "Anzahl Personen": people,
        "Einnahmen (€)": total_amount
    })


# DataFrame erstellen
df = pd.DataFrame(bookings)

# In Excel-Datei speichern
output_file = "lodgify_buchungen.xlsx"
try:
    df.to_excel(output_file, index=False, engine="openpyxl")
    print(f"✅ Daten wurden erfolgreich in {output_file} gespeichert.")
except Exception as e:
    print(f"❌ Fehler beim Speichern der Excel-Datei: {e}")
    exit(1)

Ergebnis ist eie XLS-Datei mit den Buchungen und Einnahmen